▸ Strategie
Das kurze Leben des Prompt-Engineers: Warum die Zauberformeln für die KI ausgedient haben
Im März 2023 schrieb das KI-Unternehmen Anthropic eine Stelle aus, über die Wirtschaftsmedien weltweit berichteten: „Prompt Engineer and Librarian“, Jahresgehalt 175.000 bis 335.000 Dollar. Gesucht wurde jemand, der gute Eingaben für ein Sprachmodell formuliert und in einer Bibliothek sammelt. Ein Informatikstudium war nicht verlangt, wohl aber „ein kreativer Hacker-Geist“. Wer die Sprache der Maschine beherrscht, so das Versprechen jener Monate, hat einen Beruf mit Zukunft.
Das klang plausibel, und es folgte, was auf solche Versprechen immer folgt: Kurse, Zertifikate, Vorlagenmärkte. Auch in Kanzleien wurden Sammlungen mit erprobten Formulierungen angelegt und gepflegt wie Textbausteine für Einspruchsschreiben.
Drei Jahre später, ein kurzes Leben, gibt es den Beruf so gut wie nicht mehr. Und weil in vielen Kanzleien gerade Geld für Prompt-Schulungen ausgegeben wird, lohnt ein genauer Blick darauf, was da passiert ist.
Ein Beruf verschwindet, kaum dass es ihn gab
In einer von Microsoft beauftragten Befragung von 31.000 Beschäftigten in 31 Ländern landete der Prompt-Engineer auf dem vorletzten Platz der Rollen, die Unternehmen in den nächsten anderthalb Jahren neu schaffen wollen. Auswertungen von Jobbörsen und LinkedIn-Daten zählen, je nach Abgrenzung, 79 bis 90 Prozent weniger Stellenausschreibungen mit diesem Titel als auf dem Höhepunkt 2023. Wo die Bezeichnung noch auftaucht, ist sie meist eine Zeile im Anforderungsprofil einer anderen Stelle.
Berufe verschwinden selten, weil ihre Aufgabe unwichtig wird. Meist hat jemand anderes die Aufgabe übernommen. In diesem Fall war es die Maschine selbst, und wie sie das gemacht hat, sollte man sich ansehen, bevor man die nächste Schulung bucht.
Die Tricks stehen jetzt im Trainingsmaterial
Sie kennen die Kniffe vermutlich: „Du bist ein erfahrener Steuerberater.“ „Denke Schritt für Schritt.“ „Antworte in exakt fünf Abschnitten.“ Manche haben dem Modell Trinkgeld versprochen, andere haben gedroht. Diese Formeln wirkten tatsächlich, denn frühe Modelle brauchten Führung, und wer sie geschickt führte, bekam messbar bessere Ergebnisse.
Inzwischen lernen die Modelle aus genau diesem Material. Die Anbieter trainieren jede neue Generation mit menschlichem Feedback nach; das Verfahren heißt Reinforcement Learning from Human Feedback. Auf Deutsch: Menschen bewerten Antworten, und das Modell übernimmt die bevorzugte Arbeitsweise als Voreinstellung. Jeder Ratgeber-Artikel über den besten Trick, jede veröffentlichte Prompt-Sammlung und jeder Forumsbeitrag fließt in dieses Training ein. Was gestern ein Geheimtipp war, macht das Modell heute von selbst. Damit kann der Trick nichts mehr verbessern; er ist schon eingebaut.
Die Hersteller sagen das mittlerweile selbst. OpenAI hält in seinen Hinweisen zu Reasoning-Modellen fest, die Aufforderung „denke Schritt für Schritt“ sei dort überflüssig und könne die Ergebnisse sogar verschlechtern. Anthropic empfiehlt für Claude, allgemeine Anweisungen den kleinteilig vorgeschriebenen vorzuziehen. Branchenanalysen schätzen den Qualitätsvorsprung eines ausgefeilten Prompts gegenüber einer schlicht und klar formulierten Eingabe für 2023 auf rund 40 Prozent, für heute noch auf 4 bis 6.
Solche Schätzungen mitteln über Aufgaben und Modelle, die sich schlecht mitteln lassen; auf die Nachkommastelle würde ich nichts geben. Es gibt aber eine Messung, die denselben Verfall sauberer zeigt und noch einen Schritt weitergeht.
Wenn der bessere Prompt die schlechtere Antwort liefert
Ende 2025 hat der Forscher Imran Khan drei Prompt-Strategien auf 1.317 Mathe-Textaufgaben verglichen, quer über mehrere Modellgenerationen von OpenAI (arXiv 2510.22251). Auf GPT-4o, einem Modell des Jahrgangs 2024, gewinnt der aufwendig konstruierte Regel-Prompt deutlich: 97 Prozent richtige Antworten statt 93 mit der einfachen Denkanweisung. Auf GPT-5 dreht sich das Bild. Dort kommt der aufwendige Prompt auf 94 Prozent und die einfache Anweisung auf 96,4. Derselbe Mehraufwand, der dem älteren Modell vier Punkte Vorsprung verschaffte, kostet das neuere 2,4.
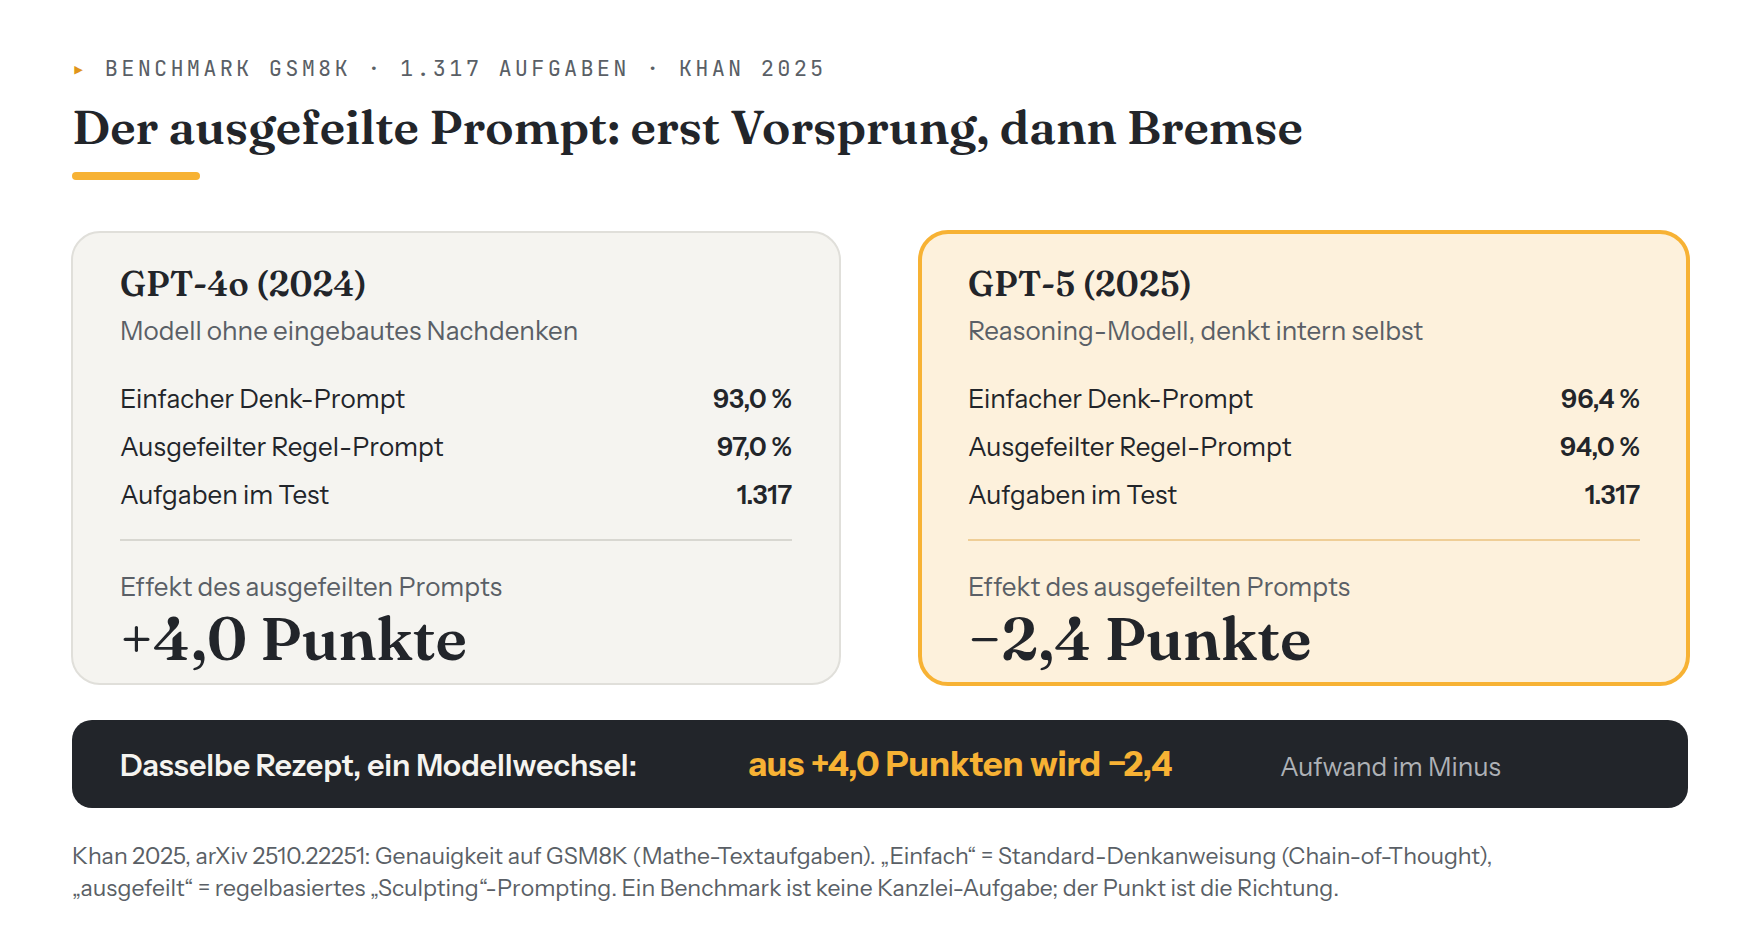
Khan nennt den Mechanismus „Guardrail to Handcuff“: Aus dem Geländer wird eine Handschelle. Kleinteilige Vorschriften bewahren ein mittleres Modell vor Leichtsinnsfehlern. Einem starken Modell zwingen sie wörtliche Regelbefolgung auf, und es rechnet schlechter, als wenn man es einfach machen ließe. Wer schon einmal einem überqualifizierten Mitarbeiter ein kleinteiliges Skript vorgegeben hat, kennt den Effekt aus der Nähe.
Zur Einordnung: GPT-4o stammt aus dem Jahr 2024. Nach zwei Jahren dieser Entwicklung ist das, bewusst überspitzt, KI-Steinzeit. Und selbst das GPT-5 aus der Studie ist heute nicht mehr der Stand der Dinge; der Zähler steht inzwischen bei GPT-5.6. Das klingt nach einem kleinen Versionssprung. Gemessen an dem, was die Modelle können, liegen dazwischen Lichtjahre, denn diese Kurve verläuft exponentiell, und mit jedem Sprung kann sich die beste Prompt-Praxis erneut umdrehen. Eine Fertigkeit mit dieser Halbwertszeit trägt kein Berufsbild. Sie veraltet in Monaten.
Was aus der Fähigkeit geworden ist
Man könnte daraus schließen, KI-Kompetenz lohne sich insgesamt nicht mehr, das Modell mache ja alles selbst. Die Fachdiskussion ist zu einem anderen Ergebnis gekommen und hat dem Kind einen neuen Namen gegeben: Context Engineering. Optimiert wird das Material, mit dem das Modell arbeitet. Welche Unterlagen sieht es, welche Vorgeschichte kennt es, welches Ziel gilt, wo liegen die Grenzen des Auftrags? Die Formulierung der Anweisung ist darin nur noch ein kleiner Teil.
Für die Kanzlei übersetzt: Was das Modell nicht wissen kann, müssen Sie ihm geben. Den Sachverhalt, das Ziel, die Abgrenzung, die relevanten Dokumente. Das ist dieselbe Fähigkeit, die einen brauchbaren Aktenvermerk von einem unbrauchbaren unterscheidet, und sie gewinnt an Wert, während die Formeln ihn verlieren. Warum für diese Aufgabe das Mikrofon oft das bessere Werkzeug ist als die Tastatur, habe ich in einem eigenen Beitrag über das Sprechen mit der KI beschrieben.
Was das für Ihre Kanzlei bedeutet
- Kaufen Sie keine Formelsammlungen mehr. Ein Kurs, dessen Kern aus Rollenzuweisungen und Zauberwörtern besteht, unterrichtet den Stand von 2023. Ihr Team lernt dort eine Arbeitsweise, die aktuelle Modelle ausbremst, und bezahlt dafür.
- Feste Prompts gehören in Prozesse. Wo ein Ablauf zwanzigmal im Monat gleich läuft, bleibt ein getesteter, fest hinterlegter Prompt richtig, so wie ein Textbaustein. Er wird beim Modellwechsel geprüft, wie Sie Vorlagen nach einer Gesetzesänderung prüfen, und er gehört in die Ablaufbeschreibung statt ins Gedächtnis einzelner Mitarbeiter.
- Schulen Sie das Bleibende. Sachverhalte vollständig erklären, Ergebnisse fachlich prüfen, Datenschutz und Verschwiegenheit einhalten: Das veraltet mit keiner Modellgeneration. Es ist zugleich der Kern der KI-Kompetenz, die Art. 4 der KI-Verordnung (EU) 2024/1689 seit Februar 2025 von jeder Kanzlei verlangt, die KI einsetzt.
Welche Abläufe sich für feste Prompts eignen, welche Umgebung die Datenlage erlaubt und wie eine Schulung aussieht, die nächstes Jahr noch gilt, sortiere ich mit Kanzleien in der Beratung und Begleitung.
Was bleibt
Der Prompt-Engineer verschwindet, weil der mechanische Teil seiner Arbeit in die Modelle eingewandert ist. Der Rest seiner Arbeit war nie mechanisch: wissen, was man will, den Fall vollständig erzählen, das Ergebnis beurteilen können. Für diese Fähigkeit hat nie jemand 335.000 Dollar aufgerufen. Sie hieß schon immer sauber arbeiten, und sie bleibt der Teil, den Ihnen kein Modell abnimmt.
▸ Erstgespräch
Lassen Sie uns Ihren Startpunkt finden.
Kostenloses Erstgespräch, danach eine rund einstündige Bestandsaufnahme Ihrer Kanzlei. Unverbindlich, mit klarem Ergebnis.
Häufige Fragen
Sind unsere gesammelten Prompts jetzt wertlos?
Nein, aber ihr Wert hat sich verschoben. Als getestete Bausteine in wiederkehrenden Abläufen bleiben feste Prompts nützlich, so wie Textbausteine in der Kanzleisoftware. Als Zauberformeln für die tägliche Einzelanfrage haben sie ausgedient. Trennen Sie beim Aufräumen zwei Dinge: Die Formulierungstricks können weg. Die guten Fallbeschreibungen behalten Sie, denn eine präzise Beschreibung eines Sachverhalts veraltet mit keiner Modellgeneration.
Was ist Context Engineering?
Der Begriff, der Prompt Engineering in der Fachdiskussion abgelöst hat. Gemeint ist die Auswahl und Aufbereitung dessen, was ein KI-Modell zu sehen bekommt: Unterlagen, Vorgeschichte, Ziel, Grenzen des Auftrags, verfügbare Werkzeuge. Die Formulierung der Anweisung ist darin nur noch ein kleiner Teil. Für die Kanzlei heißt das: Die Qualität einer Antwort entscheidet sich daran, ob dem Modell die richtigen Informationen vorliegen. Eine Formel ersetzt das nicht.
Woran erkenne ich eine veraltete KI-Schulung?
Am Verhältnis von Formeln zu Urteilskraft. Besteht der Kern des Angebots aus Rollenzuweisungen, Zauberwörtern und Listen bewährter Formulierungen, wird dort ein Stand von 2023 unterrichtet. Fragen Sie, für welche Modellgeneration die Inhalte zuletzt geprüft wurden und wie viel Zeit auf Datenschutz, Verschwiegenheit und die fachliche Prüfung von KI-Ergebnissen entfällt. Ein aktuelles Angebot behandelt die Formulierung als Randthema und diese Punkte als Kern.
Warum kann „Denke Schritt für Schritt“ neuere Modelle verschlechtern?
Weil Reasoning-Modelle interne Zwischenschritte ohnehin durchlaufen, bevor sie antworten. Die ausdrückliche Anweisung schaltet dieses eingebaute Vorgehen nicht dazu. Sie zwingt das Modell, sich an das vorgegebene Muster zu halten, und das ist oft schlechter als sein eigenes. OpenAI rät in den eigenen Hinweisen zu Reasoning-Modellen ausdrücklich von der Formel ab; knappe, direkte Aufträge funktionieren dort besser.